让电脑给一张图片的每个像素随机填色,画出一片雪花并不难。想靠同样的办法碰巧画出一只猫,机会就渺茫得多:耳朵、眼睛、毛发和背景,需要在大量位置上互相配合。
扩散模型利用了一个比较容易反复练习的任务:先把好好的图片弄脏,再学习怎样减少这些噪声。训练时能见到答案;生成时,则从一份全新的噪声开始,把学到的规律一步步用回来。
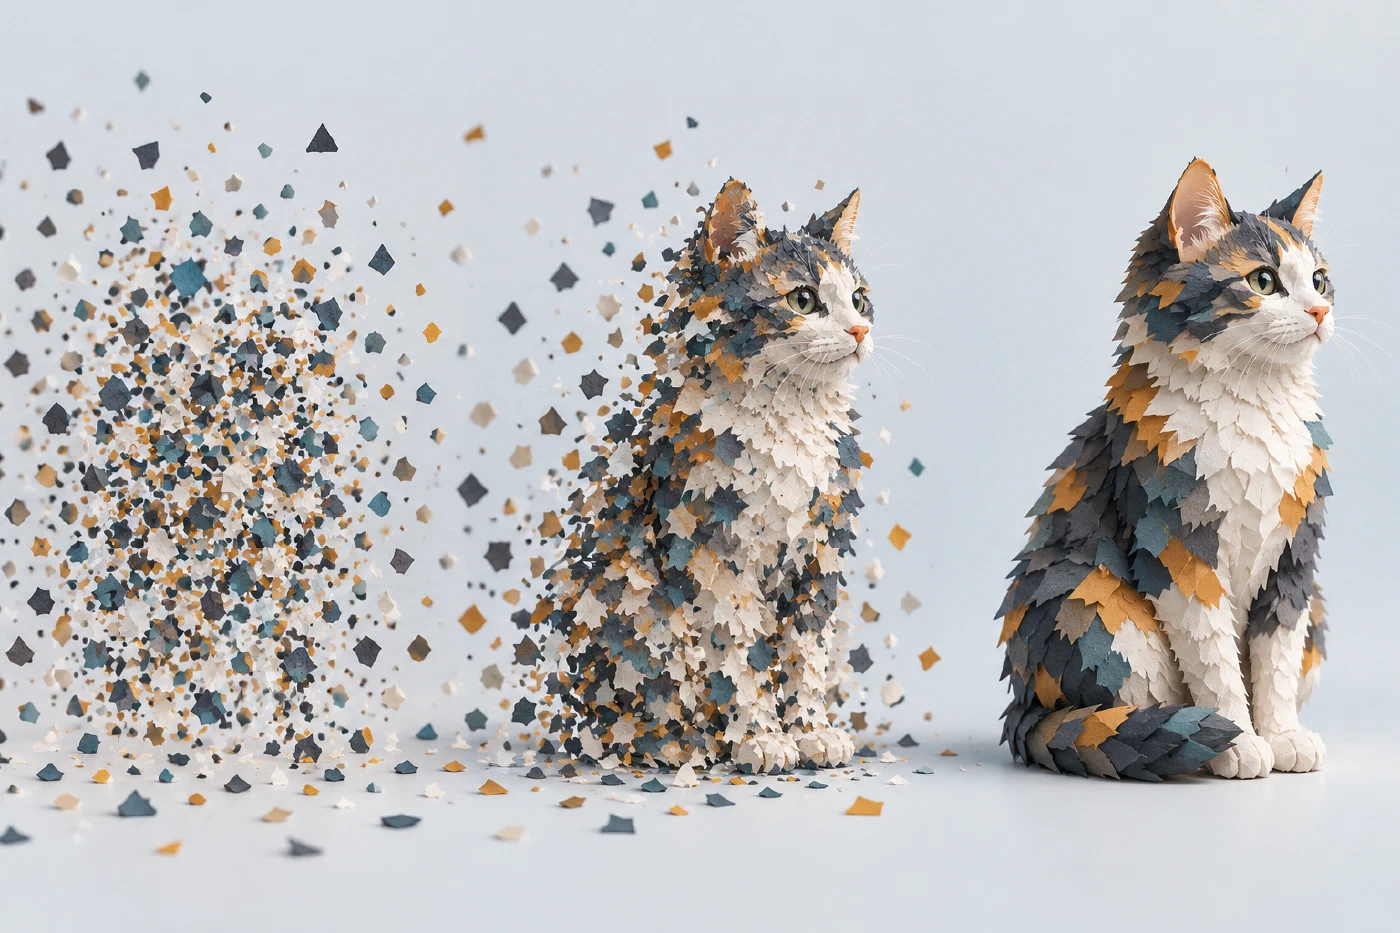
一张图,也可以住进一个点里
一张 224 × 224 的 RGB 图片,有 150,528 个红、绿、蓝通道数值。把它们按固定顺序排成一长列,就得到一个 150,528 维向量;整张图片成为高维空间中的一个点。
这个空间容得下所有乱填的像素,也容得下猫、狗、山川和人脸。但自然图像有许多共同约束:一只眼睛附近通常还有脸,相邻毛发不会毫无关联,光照也会同时影响大片区域。真正像照片的那些点,并没有均匀铺满全部可能性。
这就是流形假设的直觉。想象一张揉皱的薄纸:它弯曲着放在三维房间里,沿纸面移动却只需要两个坐标。高维数据也可能集中在内在结构简单得多的区域。这里用的是理想化的零厚度纸面;真实纸张当然有厚度。即使一张理想纸面长21厘米、宽29.7厘米,面积623.7平方厘米,只要厚度被设成零,它在三维空间里的体积仍为零。
Pope 等在 2021 年用不同近邻参数估计 ImageNet 的内在维度,得到约 26~43 的结果,与像素表示的 150,528 维形成明显反差。它是特定数据、尺度与估计方法下的测量,不能理解成“任意图片只需几十个数就能无损保存”。[2]
找到那张薄纸,为什么不容易
知道好图片集中在哪里,还不等于已经学会怎样生成它们。网络需要一种可优化的办法,比较“目前生成的分布”与“真实图片的分布”相差多少,再根据差距调整参数。
KL 散度是常见的分布差异量之一:
Dₖₗ(P∥Q)=∫ p(x) ln[p(x)/q(x)] dx
假如某些真实数据可能出现的位置,模型却给出了零概率,式子里的比值就会出问题,KL 散度可能变成无穷大。在理想化的低维、互不重叠的分布上,这种困难尤其明显。
另一种相关困难出现在 JS 散度。若两片分布完全分离,它可能停在常数 ln 2:把模型那片“薄纸”移动一点,损失几乎不变,梯度便无法告诉网络该往哪里走。KL 发散和 JS 局部饱和是不同情况,不能笼统地都说成“KL 的梯度为零”。这类支撑集与梯度问题,是分析早期 GAN 训练困难的一条线索。[3]
给数据加噪,会把原本很薄、很尖的分布逐渐抹开。不同噪声水平的分布因此更平滑,也给学习“附近该往哪边调整”提供了条件。
先把图像散开,制造一套有答案的练习
在 DDPM 的正向过程中,程序按预先设定的规则逐步加入高斯噪声。开始还能看见猫的耳朵,随后只剩模糊轮廓,噪声足够大时,整体分布接近便于采样的标准高斯分布。[1]
常用的写法是:
xₜ=√ᾱₜ x₀+√(1−ᾱₜ) ε, ε~N(0,I)
x₀ 是原图,ε 是新采样的噪声,ᾱₜ 表示到时间 t 仍保留多少原图信号。时间往后走,原图的分量变小,噪声的分量变大。这个表达式还让训练程序可以直接构造某个时间步的题目,不必每次都从头逐步弄脏图片。
用二维图来想象,高维的图片数据可以暂时画成一条细曲线。加噪后,曲线周围变成一条宽带;噪声继续增加,原来的弯曲结构逐渐被一团分散的点云盖住。这幅示意讲的是分布怎样变化,不是图片真的只有两个维度。
- 构造题目:抽一张图片、一个时间步和一份噪声,计算带噪图像。
- 让网络作答:输入带噪图像与时间步,预测加入的噪声。
- 比较答案:用预测噪声与已知噪声的均方误差调整参数。
标签由加噪过程自己产生。轻度噪声和重度噪声的题目都要练习,时间步则告诉网络当前的噪声水平。
扩散概率模型在 2015 年已有研究;2020 年 Ho、Jain 与 Abbeel 的 DDPM 把噪声预测与训练、采样的联系做得更清楚,并展示了高质量图像生成。[5]
墨水的倒放,要倒回的是分布
一滴墨水在水中散开,看上去很像加噪。可一滴墨水中的每个粒子都有自己的随机路径,盯着某一个粒子,并不能凭空找回它昨天走过的路。
生成所需要的是另一种倒放:从许多可能的噪声状态出发,恢复数据整体的分布。Anderson 在 1982 年讨论的反向扩散结果,以及后来的得分模型,把这种想法写成了可求解的随机过程。[4]
在扩散强度只依赖时间的一类模型中,正向与反向可写成:
正向:dx=f(x,t) dt+g(t) dW
反向:dx=[f(x,t)−g(t)² s(x,t)] dt+g(t) dW̄
f 描述原有的确定性变化,g 控制随机扰动,W 与 W̄ 表示相应方向上的布朗运动。反向式中的时间由 T 向 0 运行,dt 为负,不能把其中的减号脱离时间方向理解。
关键的新信息是 Score,也就是得分函数:
s(x,t)=∇ₓ ln pₜ(x)
它是在当前噪声水平下,对数概率密度相对于位置的梯度。可以把它想成每个位置旁边的一根小箭头,指出局部密度上升的方向。这里求导的是对数密度,也不保证一根箭头能直接指向全局最密集的点。
这些随位置、时间变化的箭头共同组成向量场。学会这个场,就有办法在不同噪声水平下逐步调整样本。反向扩散一般仍有随机项;某些采样方法也能使用相关的确定性路径,不能把所有方法都简化为完全相同的直线回程。
同一个带噪点,为什么会有不同答案
一小团灰色像素,可能来自一只被重度加噪的猫,也可能来自一条狗,甚至一片山景。若每份训练材料都要求网络“朝它自己的原图返回”,同一个附近位置就会遇到方向不同的标签。
均方误差训练提供了一个有用的答案:在给定输入时,最优预测是各个可能标签的条件平均值。可以先看最简单的加噪方式 y=x₀+σε:
∇ᵧ ln pσ(y)=E[(x₀−y)/σ² ∣ y]
若把有限的训练样本当作等权候选,每个候选的权重还可写成:
wᵢ ∝ exp[−‖y−x₀⁽ⁱ⁾‖²/(2σ²)],再归一化为∑wᵢ=1。
在同样的高斯噪声尺度下,更可能产生当前带噪点的原图,会获得更大权重。右侧的条件期望是“那些可能原图分别指向哪里”的加权平均,恰好与带噪分布的 Score 相连。网络预测噪声,也就能通过相应的比例与符号转换,估计去噪所需的方向。
因此,它不需要替每团噪声猜出唯一的原始照片。它学习的是:在这一噪声水平、这一位置,怎样调整更符合训练数据的统计结构。随着噪声逐步减小,原本混在一起的可能性才逐渐分开。
从同一片雪花,走向猫或狗
训练完成后,先采样一份新的噪声,再根据时间步反复调用网络。一个阶段找大体结构,后续阶段继续形成轮廓、颜色和纹理;每一步都用上前面练习过的去噪规律。
不加条件时,结果的类别可能不同。想画猫,需要把“猫”的语义也交给网络。文本编码器先把提示词变成向量,网络在去噪的各个阶段结合这个条件,估计符合条件的调整方向。
可以把同一份初始噪声分别配上“猫”和“狗”:开局看起来一样,后续的选择却会受到不同条件影响,逐渐形成不同的形状。提示词参与的是整个生成过程,而不只是在最后给成品贴标签。
这里讨论的是一条理解扩散生成的路径。实际系统还会选择不同的预测目标、采样器,或先把图像压缩到潜空间再处理;“把图片弄脏,再学会逐步减少噪声”这条线索,能把像素空间、概率分布、训练标签和文字条件接到一起。