“床前明月——”
如果约定接的是李白的《静夜思》,又恰好熟悉这首诗,“光”字还没出现,心里多半已经把它补上了。换成“那天夜里,窗外下起了——”,雨、雪、花瓣,甚至一个故意出人意料的词,才会留下更多可以等待的可能。
信息论研究这份不确定性:在怎样的概率模型里,一个结果出现,替我们排除了多少原有的可能。这个量可以计算,但“算出了多少信息”和“这句话有什么意义”,还不是同一个问题。
十个问题,找到一个数
从1到1024里选一个整数,每次只能回答“是”或“否”。如果要保证找到答案,十个问题已经足够;想用九个问题覆盖全部1024个可能,则不够,因为九个二选一最多区分512条完整的回答路径。
办法是每次把剩下的候选分成尽量相等的两半。假设谜底是693,一条完整的过程可以是:
| 第几问 | 问题 | 回答 | 剩下的范围 |
|---|---|---|---|
| 1 | 比512大吗? | 是 | 513~1024 |
| 2 | 比768大吗? | 否 | 513~768 |
| 3 | 比640大吗? | 是 | 641~768 |
| 4 | 比704大吗? | 否 | 641~704 |
| 5 | 比672大吗? | 是 | 673~704 |
| 6 | 比688大吗? | 是 | 689~704 |
| 7 | 比696大吗? | 否 | 689~696 |
| 8 | 比692大吗? | 是 | 693~696 |
| 9 | 比694大吗? | 否 | 693~694 |
| 10 | 比693大吗? | 否 | 693 |
把“是”记作1,“否”记作0,这条问答路径就是1010110100。它编码的是上述十次判断;若把候选按0~1023编号,对应编号692,也就是第693个候选。
候选数依次变成512、256、128,最后剩1个。若最初各数等可能,每次平分的回答平均带来1比特,十次就是10比特;log₂1024=10。
香农在1948年的《通信的数学理论》中,把这种二进制对数的度量放进通信理论,也注明“bit”这一用语由John Tukey建议。[1] 比特可以衡量信息量,也可以表示一个二进制存储位的容量;具体说的是哪一个量,需要结合模型。
一堆平静日子,和突然点亮的烽火
假设一套警报模型认为,某天有情况的概率为1/365,没有情况为364/365。听到“今天仍然平静”,主要是在确认一个本来就很可能的结果;听到警报,才排除了大量原本占优势的预期。
概率为p的一个结果,自信息量为:
I=−log₂p
| 示例结果 | 假设的概率p | 自信息量 |
|---|---|---|
| 警报模型中的平静一天 | 364/365 | 约0.004比特 |
| 警报模型中出现情况 | 1/365 | 约8.51比特 |
| 某天气模型中的常见结果 | 0.999 | 约0.0014比特 |
| 同一模型中的罕见结果 | 0.001 | 约9.97比特 |
可以把最后两行想成“广州明天不下雪”和“广州明天下雪”的示意,但0.999和0.001只是为计算设定的概率,不是广州的气候统计或天气预报。换一座城市、一个季节或一套已有信息,概率就可能不同。
这里的“惊奇”也不等于心理刺激有多强。它依赖消息出现前采用的概率模型,不会单凭标题耸动就自动变大,更不替消息的真假背书。
单条消息的惊奇,和平均的不确定性
把每种结果的自信息量按其概率求平均,就得到信息熵:
H=−∑pᵢ log₂pᵢ
对一个只可能“是或否”的问题,若双方各占一半,回答前最难押中,平均信息熵为1比特。若答案几乎总是“否”,平均不确定性就小得多。
这和罕见结果有将近10比特自信息量并不矛盾。1比特是一个二元分布的平均熵上限;那条10比特的罕见结果,出现机会也很小,要乘上自己的概率后才进入平均值。
所以,“惊奇”是理解信息量的一个入口,实际单位仍是采用二进制对数时的比特。单条结果的信息量、整个分布的熵,以及写下消息需要多长的编码,要分开辨认。
猜得到的部分,既能被压缩,也能帮忙补缺
“下一站是终点站,请带好您的随身物品。”这类熟悉的广播,哪怕被噪声遮住几个字,仍可能被上下文补全。可预测的结构,提供了某种冗余。
中文的少量错序,或英文单词内部的字母交换,有时也能被读者纠正。但“字的顺序不影响阅读”并不是普遍规律。词汇是否熟悉、句子是否有足够背景、错位发生在哪里,都影响理解;Matt Davis对那段著名“剑桥研究”网络文字的说明,也专门指出了这种过度概括。[4]
无损压缩利用重复和统计结构,用较短的表示替代较长的表示,再按照约定规则恢复。它并不真的随手删掉一些字,指望读者猜对。若要保证逐字恢复,解码端必须拥有足够的规则和信息。
传输则有另一种需要:为可能受损的消息加上可检验的结构。比如把1编码成111,把0编码成000,接收端按多数决定。111变成101时能恢复为1;两位一起翻错,简单多数就可能判断错。这个例子牺牲了效率,却使“多一些结构,可以少一些错误”变得直观。
噪声很大,为什么还能通信
对相应的有噪信道模型,信息传输有一个容量。只要速率低于容量,通过适当编码和足够长的码字,错误概率就可以做到任意小;它不是有限长度、任意环境下的零错误承诺。
对于带宽受限、加性白高斯噪声这类经典模型,常见的香农—哈特利公式是:
C=B log₂(1+S/N)
B是带宽,S与N是按同一口径计量的信号和噪声功率,C的单位是比特每秒。它说明容量与带宽、信噪比有关,但不能脱离信道假设,拿来直接计算所有现实链路。[1]
- 编码:把消息变成有规律、可以检验的表示。
- 经过信道:信号可能衰减,部分内容受到噪声干扰。
- 解码:利用收到的信号与编码结构,判断原来的消息。
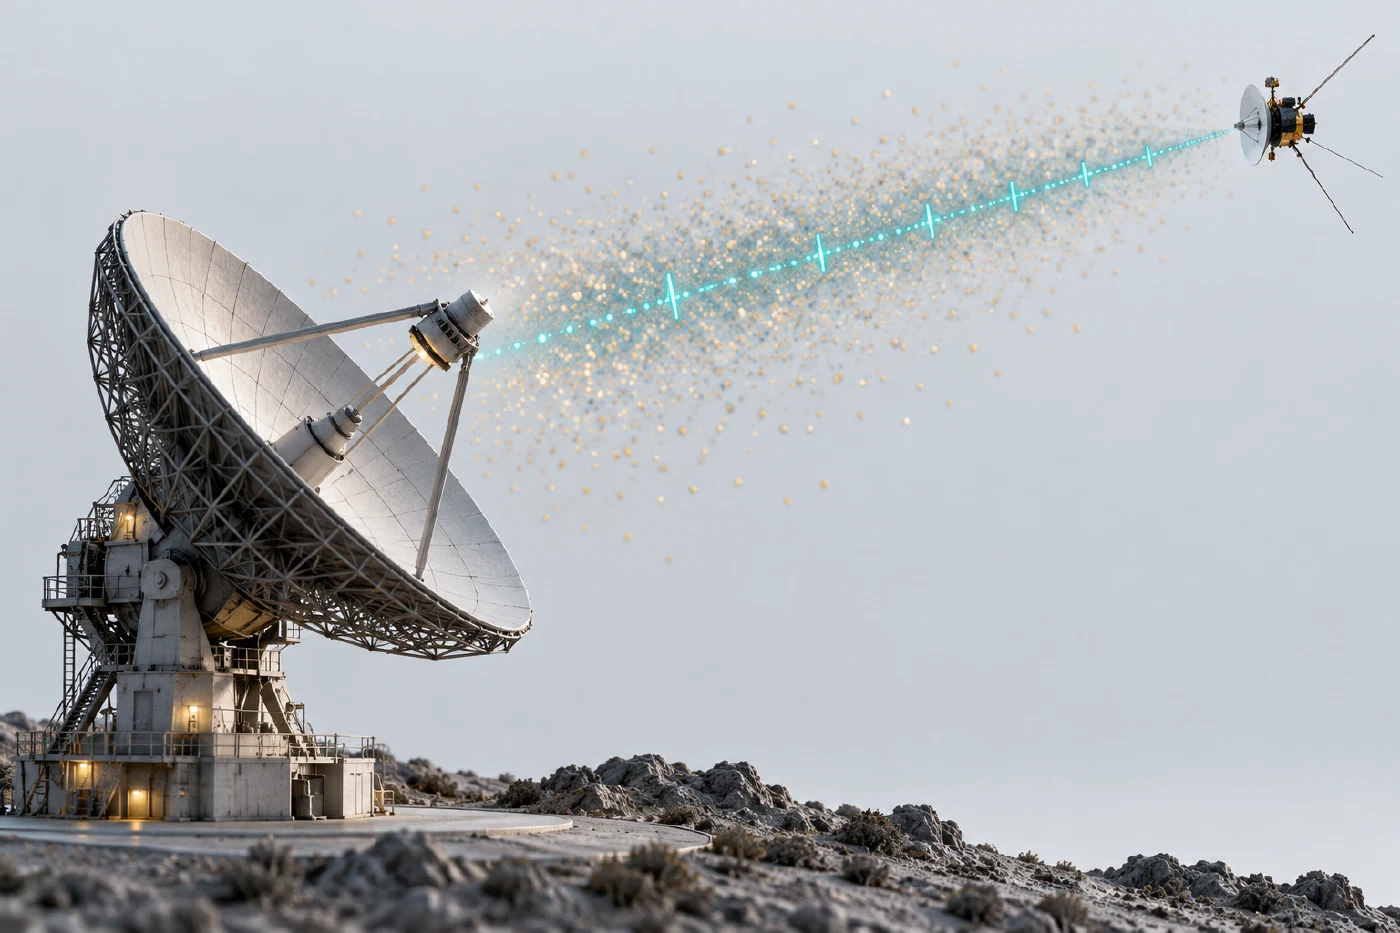
旅行者的例子把这种困难推得很远:发射机约23瓦,跨越的是连光也要走很久的深空距离。JPL的资料给出过旅行者1号往返信号超过44小时的距离示例。如此微弱的接收信号,依靠定向天线、地面大口径接收站、低噪声设备、编码与处理共同工作,仍然能传回科学数据。[2]
这体现的是整套通信系统的能力,不能简化成“只靠20瓦,任何时候每一个比特都保证被识别”。
清走鸽子之后,噪声还在
1964年,Penzias与Wilson在贝尔实验室排查天线中的异常噪声。设备可能有问题,环境可能有干扰,天线里的鸽子与污物也被清理过。那份难以消除的背景,却仍然存在。Wilson在诺贝尔演讲中回忆了这段排查过程。[5]
后来被认识到的,是宇宙微波背景辐射。它与早期宇宙有关:在通常的宇宙学图景中,今天可见的这份古老光,来自大爆炸约38万年后宇宙变得透明的时期;宇宙的常用年龄估计约为138亿年。[6]
对接收目标信号的任务,某种背景可能是噪声;换一个科学问题,它又可能成为需要解释的数据。发现并不是因为“噪声多就一定有大秘密”,而是排除已知来源后,那份稳定残余仍要求一个解释。
一首诗和乱码,可以占同样多的位置
香农刻意把语义问题与通信工程问题分开。假如把七个常用汉字统一按16位编码,“春风又绿江南岸”与七个杂乱汉字都可占112比特。若改用UTF-8,这些常用汉字通常各占3字节,长度又会不同。编码长度相同,不代表读者获得的意义相同。
洪迈《容斋续笔》的“诗词改字”记载,王安石在“春风又绿江南岸”一处,曾在“到”“过”“入”“满”等字之间修改,最后定为“绿”。这是古籍中的创作轶事,不是某个公式计算出了最好的诗句。[7]
“绿”带来变化,也能与春风和江岸连起来。完全不可预测的乱码,却可能缺少让读者理解的规则。数学上的信息量、可理解性、真实性和审美价值,彼此有关联,却不由同一个比特数替代。
推荐流如果总沿着熟悉的方向走,新的材料可能越来越容易被预料;但故意找最离奇的东西,也不会自动带来知识。一部陌生领域的书、一个想法不同的人、一条没走过的路,只有在能够理解、比较和核验时,才更可能改变原来的认识。
再回到那个空白:“那天夜里,窗外下起了——”。填什么会出人意料,填什么又能让人理解,是两个值得同时保留的问题。